重複をなくして、共通の処理にまとめる。読みやすく直しやすいコードを書くために、多くの開発者が身につけてきた定石です。
ところが、AIに保守を任せるようになって、この定石が裏目に出る場面に出会いました。テストで見つかったある業務の不具合を、AIに直してもらったときのことです。AIは共通関数を修正し、ユニットテストも通しました。ところが同じ関数を使っていた別の業務の処理まで、期待とは違う動きに変わっていたのです。
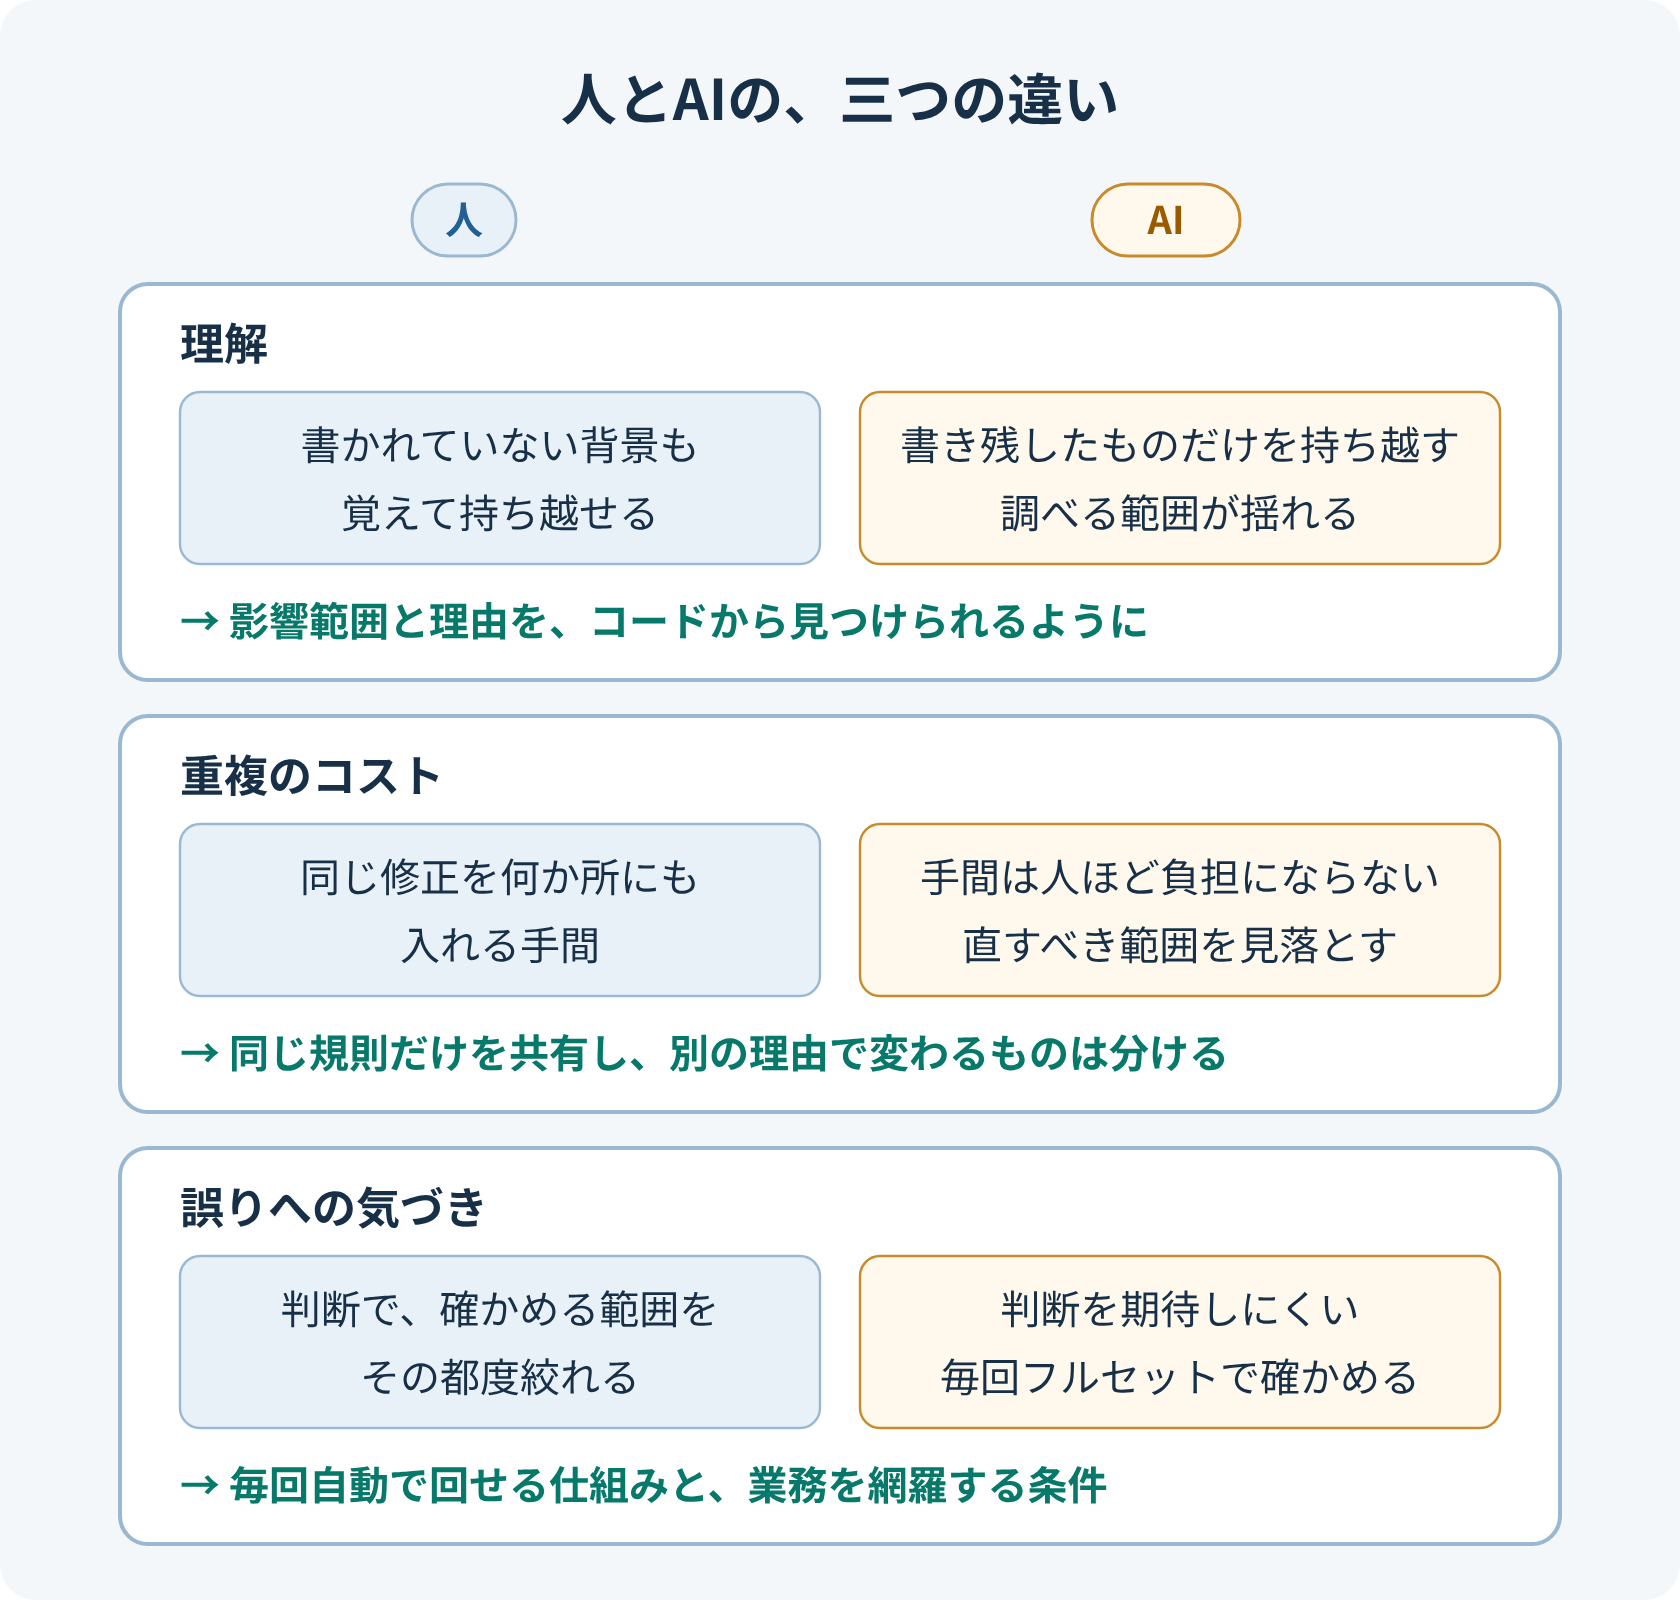
人にとって保守しやすいコードは、AIにとっても保守しやすいのでしょうか。私たちの答えは、「設計の原則は変わらない。ただし、どの原則を重く見るかが変わる」です。その理由は、人とAIの間にある三つの違いにあります。
人とAIの、三つの違い
- 理解を持ち越せるか。AIが作業をまたいで持ち越せるのは、書き残したものだけです。
- 重複のどこにコストがあるか。AIにとって高くつくのは、直す手間より、直す範囲の見落としです。
- 誤りにどう気づくか。どこまで確かめれば十分かの判断を、AIには期待しにくくなります。
以下、違いごとに、何が起きるのかと、設計やテストでどう補えるのかを見ていきます。設計の例は、説明のために構成した仮想例です。
違い1:AIが持ち越せるのは、書き残したものだけ
人は担当を続けるうちに、コードに書かれていない背景を覚えていきます。「この共通関数は夜間バッチでも使っている」「この分岐は、特定の取引先との取り決めで残している」。次の改修では、その記憶を手掛かりに影響範囲を探せます。
AIが作業をまたいで持ち越せるのは、コードや資料、作業ルールのように書き残したものだけです。それ以外は、作業のたびに組み立て直します。私たちの開発でも、同じ指示を出しているのに、そのときどきの理解の揺れで調査範囲を正しくとれず、修正範囲を読み違えることが何度もありました。
指示を工夫するだけでは、この揺れはなくせません。そこで効いてくるのが、影響範囲や判断の理由を、コードの側から見つけやすくしておくことです。AIエージェントを開発するAnthropicも、ファイルのパスやフォルダの構成、命名の規則を手掛かりに、必要な情報をその都度読み込ませる探索の仕方を紹介しています。[1] その手掛かりを整えておくのです。
呼び出しを、検索でたどれる形にする
たとえば、割引の計算を直すとします。請求処理には、割引を適用するメソッドの呼び出しが一行あるだけです。そのメソッドは親クラスで定義され、実際の計算は子クラスに任されています。どの子クラスを使うかは設定ファイルで決まり、一部の取引先には別の計算が登録されています。
人なら、この仕組みは一度覚えれば済みます。AIは、作業のたびに継承と設定をたどり直します。しかも設定ファイルでの登録のように、実際にどの実装が選ばれるかが実行時まで決まらない継ぎ目は、呼び出しを追うだけではたどれず、設定や登録の仕組みまで読みに行く必要があります。そこでAIが、修正すべきものとは別の実装を読んでしまうことがあります。
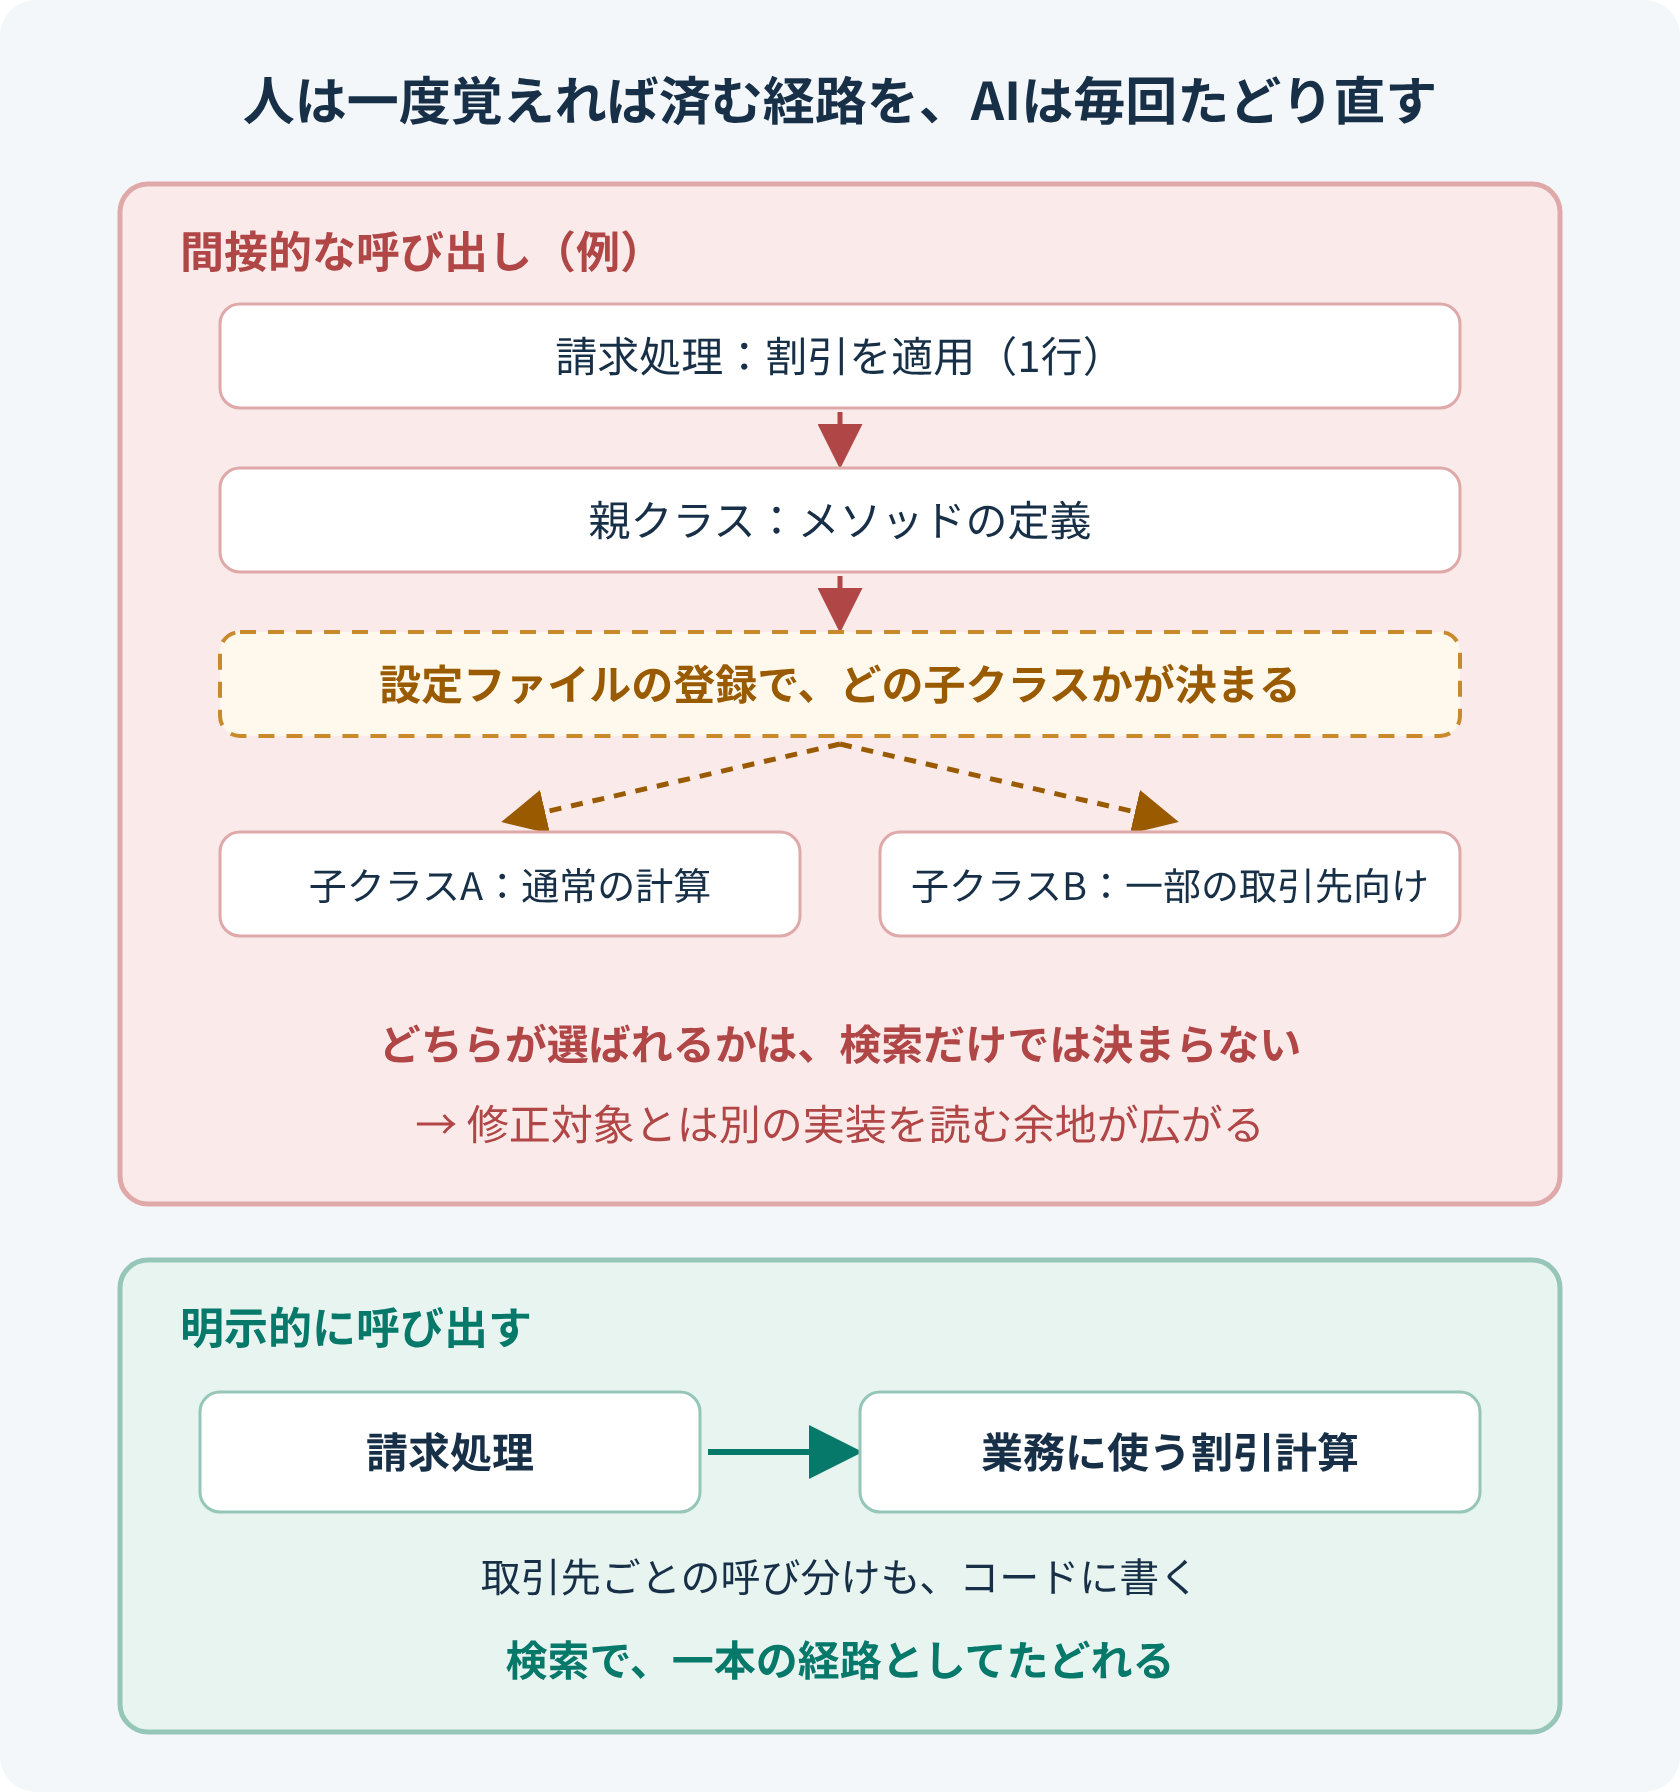
請求処理から使う割引計算を明示的に呼び出し、取引先ごとの呼び分けもコードに書いておけば、経路は検索で一本につながります。取引先が増えるたびにコードの変更が要る、という代償はありますが、たどりやすさを優先する価値は、AIが保守するなら大きくなります。
抽象化そのものが悪いわけではありません。「決済を依頼すると、成功・失敗・結果未確定のいずれかが返る」という約束が安定していれば、利用する側は個々の決済サービスの中身を読まずに済みます。見るべきは、その抽象化によって何を知らずに作業でき、必要なときに実体まで検索でたどれるかです。
変更の単位で、置き場所をまとめる
注文の取消に、理由の入力を追加するとします。画面、データ型、入力チェック、保存処理、テストが関わる変更です。これらが画面、サービス、テストといった技術的な分類だけで配置されていると、AIは毎回、あちこちから関係するファイルを探し集めることになります。注文取消という業務の単位でまとまっていれば、そのフォルダを起点に、関係する実装とテストが見つかります。よくある変更の単位と、ファイルのまとまりを近づけておくことが、AIの探索の手間を減らします。
「なぜ残しているか」を、コードの近くに書く
注文取消のコードに、出荷済みの場合だけ別の処理へ進む分岐があるとします。「出荷済みなら別処理を呼ぶ」というコメントは、コードを読めば分かることです。「出荷済みの注文は、現物の返送確認が必要なため、返品手続きとして扱う」と書いてあれば、分岐を残している理由が分かります。
この理由がどこにもなければ、AIに処理の整理を頼んだとき、似た処理として統合する提案が出てもおかしくありません。理由をコードの近くに書き、出荷前と出荷後の違いを確かめるテストを置いておけば、AIは変更のたびに、守るべき条件として見つけられます。
違い2:AIにとって高くつくのは、直す手間より範囲の見落とし
人が重複を嫌うのは、同じ修正を何か所にも入れる手間がかかり、そのうち一か所を直し忘れるからです。共通関数にまとめれば、その両方を減らせます。
AIにとって、同じ修正を何か所にも入れる手間は、人ほどの負担になりません。代わりに、共通関数が、影響を見落とす入り口になります。冒頭の件がそうでした。最初にAIに渡したのは不具合の報告だけで、影響範囲の調査は求めていませんでした。どの業務から呼ばれているかは、検索すれば分かります。分からないのは、それぞれの業務が共通関数に何を期待しているかです。別の業務の期待は回帰テストとしてはありましたが、共通関数の側からは見つけにくく、修正の段階ではAIに渡していませんでした。そのテストが失敗して、ようやく気づいたのです。同じことは、この件に限らず何度か起きています。経緯は前回の記事「AIに任せた開発は、なぜ「つなぐところ」でつまずくのか」で紹介しました。
同じ規則は共有し、別の理由で変わるものは分ける
通常の注文と定期購入で、同じ送料計算を共通関数にまとめているとします。地域と重量から料金を求め、一定額以上なら無料にする計算です。
そこに「定期購入は、購入回数が3回を超えたら送料無料にする」という要望が入ります。共通関数に購入回数を足せば、差分は小さく済みます。しかし、通常の注文ではその引数をどう扱うのか、ほかの呼び出し元に影響はないのかを確かめなければなりません。別の業務の条件が集まるほど、一つの修正で調べる範囲は広がります。
かといって、送料の処理を業務ごとに丸ごと複製すると、今度は「配送会社の料金改定を、すべての注文に反映する」ときに、複製したすべての料金表を直す必要が出てきます。AIは何か所でも直せますが、直すべき箇所をすべて見つけられるとは限りません。
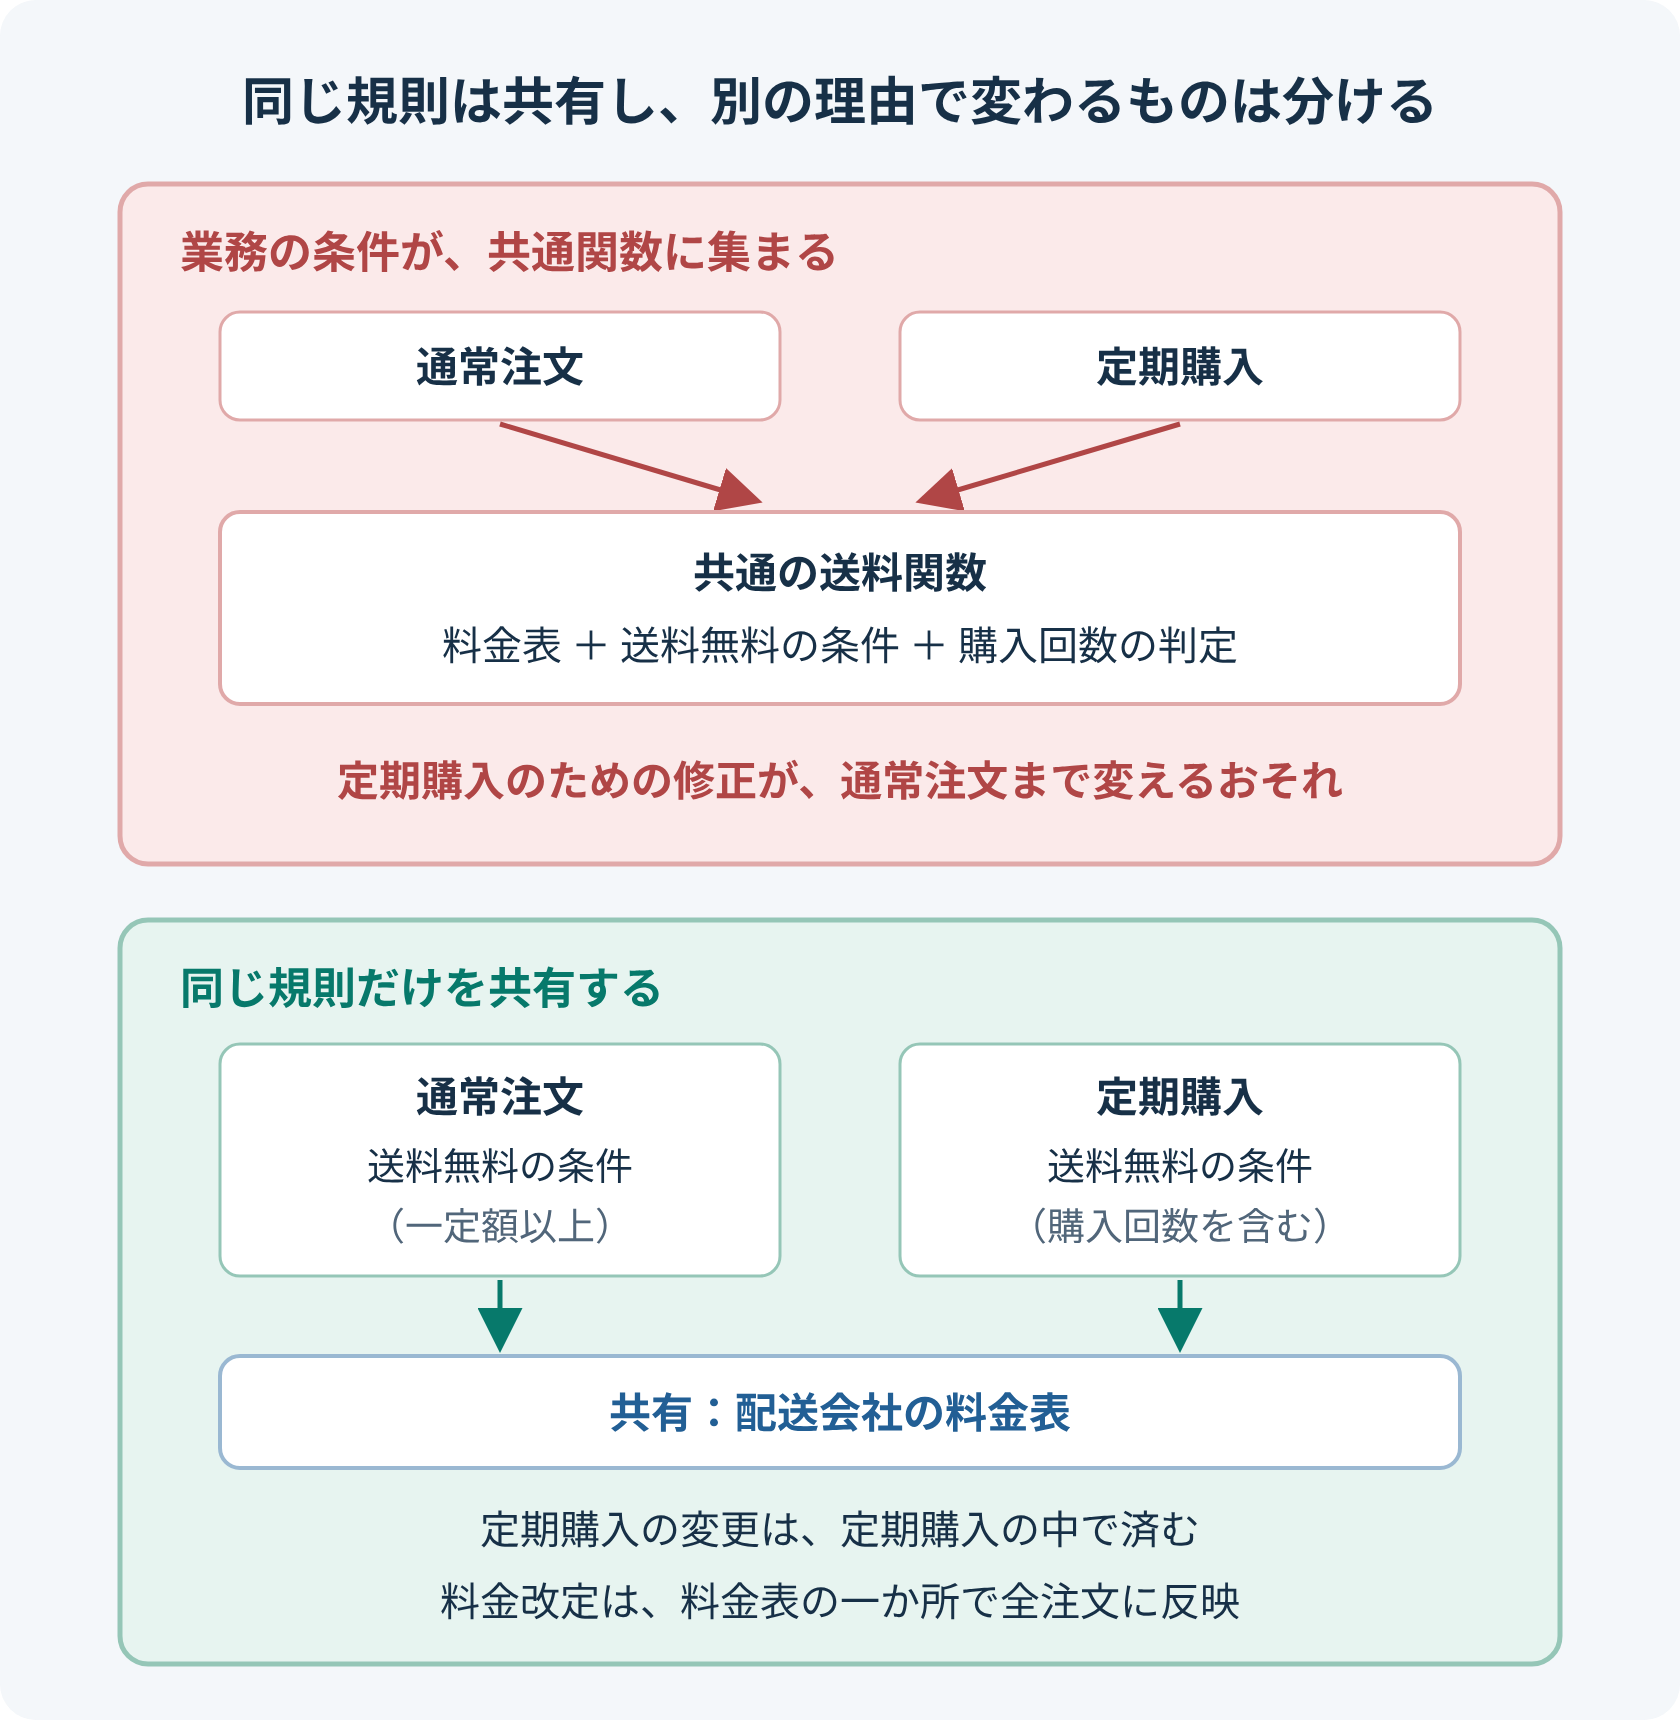
答えは、配送会社の料金表は共有し、送料無料の条件は業務ごとに持つ、という境界の引き方です。同じ規則に従う部分は共有し、別の理由で変わる部分は分ける。問うべきは重複の量ではなく、同じ規則が一か所にあり、別の規則が混ざっていないかです。
条件を継ぎ足して育った共通化をいったん呼び出し元ごとの重複に戻し、いまの要件に合わせて作り直す方法は、AI以前からSandi Metzが勧めてきました。[2] AIが保守するなら、この判断はさらに取りやすくなります。重複に戻す手間は小さく、共有の見落としによる代償は大きいからです。
共通関数には、呼び出し元ごとの期待をテストで残す
共通関数を残すなら、それぞれの呼び出し元が何を期待しているかを、呼び出し元ごとのテストとして書いておきます。通常注文ならこの条件で無料、定期購入ならこの条件で無料、というように、業務ごとの期待値を並べるのです。そうすれば、共通関数に手を入れたAIは、別の業務の期待を壊した時点で、テストの失敗として気づけます。
AIへの作業ルールとして、「共通関数を変更する前に、呼び出し元を列挙し、それぞれの期待する結果を書き出してから修正方針を立てる」と決めておくのも有効です。
違い3:どこまで確かめれば十分かの判断を、AIには期待しにくい
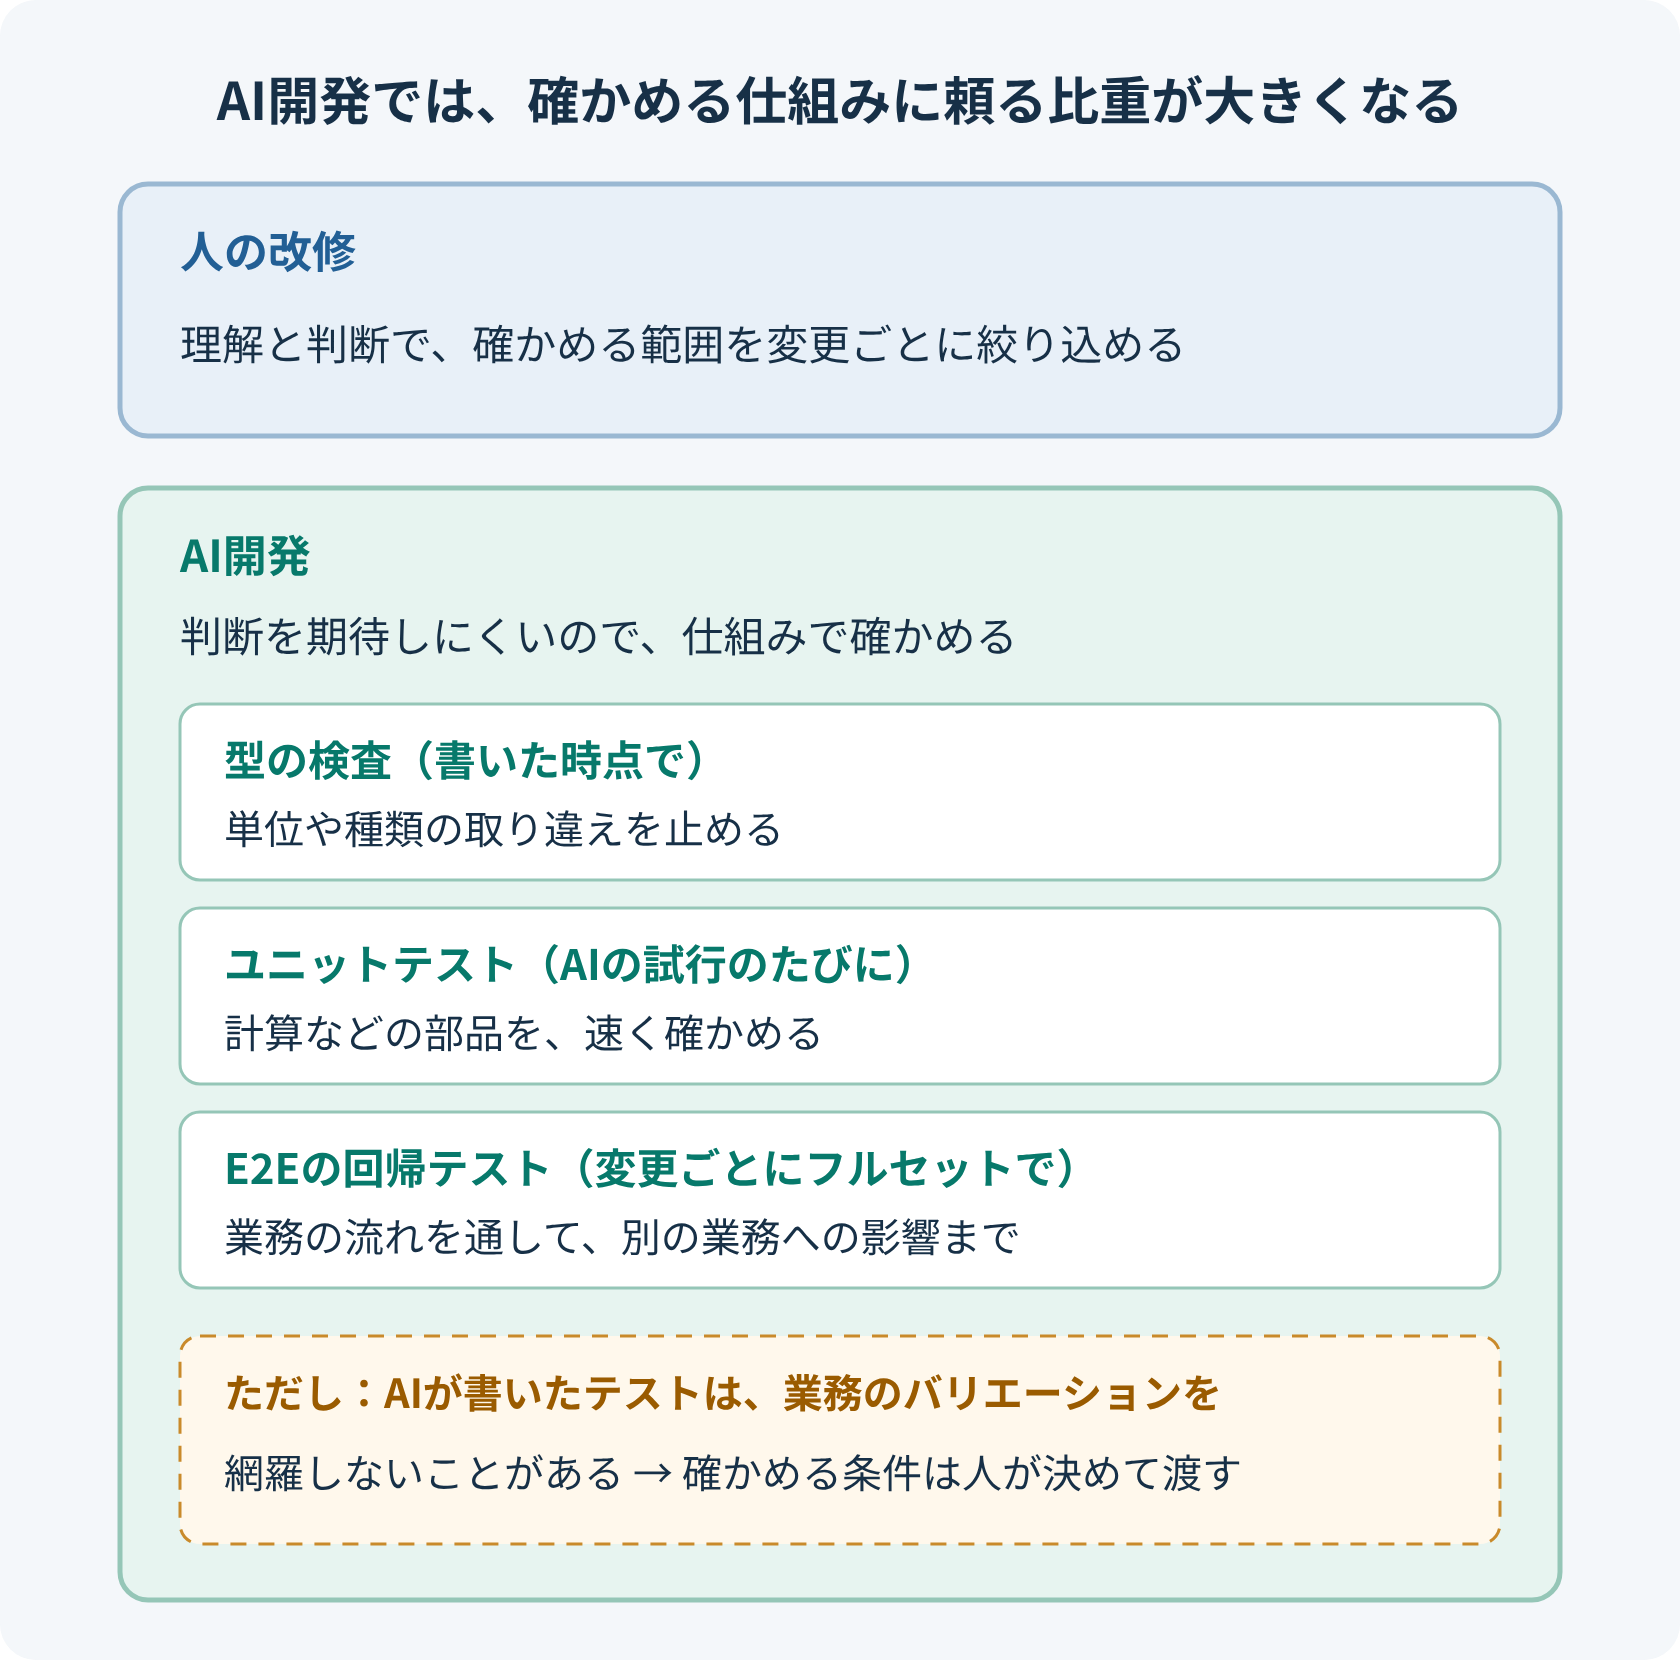
人が改修するときは、理解と判断にもとづいて、テストの量や方向を調整します。「この変更なら、この画面とこの帳票を確かめれば十分だ」という見極めです。AIの理解は、違い1のとおり作業のたびに揺れます。確かめる範囲の見極めも、同じように揺れると考えたほうが安全です。そのためAI開発では、変更のたびに回帰テストをすべて回すのが基本になります。
では、すべて回せば安心かというと、そうではありませんでした。私たちは当初、ユニットテストの全件実行を回帰テストにしていました。ところが総合テストで、業務上のパラメータのバリエーションを変えて試したところ、ユニットテストでは押さえきれていなかった条件分岐の不足が見つかりました。テストもAIに書かせていたため、業務のバリエーションを網羅する形になっていなかったのです。
AIが書いたテストは、AIが実装したときと同じ理解の上に立っています。実装で見落とした業務の条件は、テストでも見落とされやすい。テストが何件あっても、すべて通っていても、それだけでは業務の条件を確かめたことにはなりません。
業務の流れを通したE2Eのテストにすると、部品ごとには見えない組み合わせで不具合が見つかることはあります。ただ、E2EのシナリオもAIが書くなら、何を網羅するかの観点がAIの理解に頼っている点は変わりません。確かめるべき業務のバリエーションは、人の側から渡す必要があります。
取り違えを、型で書いた時点で止める
外部サービスの待ち時間を30秒から60秒に変えるとき、コードに timeout = 30 とだけ書かれていたら、秒なのかミリ秒なのかは呼び出し先を調べるまで分かりません。似たAPIを知っているAIが、別の単位を前提に変えてしまうこともあり得ます。時間の長さを表す専用の型を使い、受け取る側もその型を要求するようにしておけば、静的な型検査のある言語では、単位の取り違えは書いた時点で止まります。金額と通貨、注文IDと顧客IDなども同じです。すべての値に型を作ると定義を探す手間が増えるので、取り違えが起きやすく、影響の大きいところから導入するのが現実的です。
部品は速く、業務の流れは毎回確かめる
月末の請求処理で端数の扱いを変えるとします。計算の部分をデータベースや時刻の取得から切り離し、入力に対して結果を返す形にしておけば、境界となる金額の例で、AIの試行のたびに短時間で確かめられます。そのうえで、変更の最後には、業務の流れを通したE2Eの回帰テストで、別の業務への影響まで確かめます。毎回すべてを確かめるなら、環境の準備から確認までを、人の手を介さずに回せることが欠かせません。
どのテストでも、期待する結果は実装から写すのではなく、業務の規則から決めます(決め方は前回の記事で紹介しました)。そして、業務上どんなステータスやパラメータの組み合わせを確かめるべきか、その一覧は、テストの記述をAIに任せる場合でも、人の側で決めてAIに渡します。
AIに合わせて、人が読みにくくなっては意味がない
AIが保守するコードも、最終的には人がレビューし、人が責任を持ちます。幸い、ここまで挙げた工夫のほとんどは、人にとっても読みやすいものです。変更の単位でまとまった配置、検索でたどれる呼び出し、理由の書かれた分岐、用途の分かる型、自動で回るテスト。どれも、人の引き継ぎにも役立つものです。注意したいのは、AIの都合だけで重複を増やし、レビューする人が「それぞれ同じ規則に従っているか」を確かめる手間を増やしてしまうことです。
システムの開発を発注する側の方へ
AIを使った開発では、コードを書く手間が減る一方で、影響範囲の調査と回帰テストにコストが移ります。また、業務上どんなバリエーションがあり得るかは、業務を知る側にしか出せません。
- 業務のバリエーションを、一覧で。取引先の区分、注文の状態、例外的な扱いなど、「こういう場合もある」を早い段階で出していただくと、テストの観点としてそのまま使えます。
- 共通にしてよい規則と、業務ごとに違う規則の区別。同じに見えて理由が違う規則があれば、それが設計の境界になります。
まとめ:原則は変わらない。重みが変わる
AIが保守を担うようになっても、変更の理由で分ける、約束を明確にする、確かめやすく作る、といった原則は変わりません。変わるのは、その重み付けです。
- AIが持ち越せるのは書き残したものだけ。だから、影響範囲と判断の理由を、コードの側から見つけられるようにする。
- AIにとって高くつくのは範囲の見落とし。だから、同じ規則だけを共有し、別の理由で変わるものは分ける。共通関数には、呼び出し元ごとの期待をテストで残す。
- どこまで確かめれば十分かを、AIには任せにくい。だから、毎回すべてを自動で確かめ、確かめる業務の条件は人が決めて渡す。
人のための保守性の物差しだけでは、AIにとっての変更しやすさを測りきれない可能性は、研究でも示されています。AIが書いたコードを後続のAIが引き継いで変更する実験(プレプリント)では、人が書いたコードを引き継ぐ場合より課題の解決率が下がる条件があり、従来の保守性の指標の多くでは、その差を説明できませんでした。[3] 比べたのは「誰が書いたコードか」で、設計の流儀ではありません。それでも、どの構造がAIにとって変更しやすいかは、実際に次の変更を任せてみて確かめる必要がある、と私たちは受け取っています。
人が読んで分かることに加えて、AIが必要な情報を見つけ、誤りに気づき、次の変更を完了できること。コードを読む相手にAIが加わった今、「保守しやすいコード」の物差しは、そこまで広げて考える必要があります。
参考資料
- Anthropic. Effective context engineering for AI agents(2025年9月29日)。コンテキストを有限の資源として扱う考え方と、ファイルのパスや命名などを手掛かりにした探索。
- Sandi Metz. The Wrong Abstraction(2016年1月20日)。誤った抽象化をいったん重複に戻して見直す方法。
- Shaswat Patel ほか. Is Agent Code Less Maintainable Than Human Code?(arXivプレプリント、2026年6月投稿、2026年9月29日改訂)。エージェントが書いたコードと人が書いたコードを、後続のエージェントが引き継いで変更する比較実験。
割引の計算、決済、注文取消、送料計算、待ち時間、月末の請求処理の例は、説明のために構成したものです。資料確認日:2026年10月17日