AIに目的を伝えれば、そこへ向かう手段はうまく考えてくれる。AIに仕事を任せ始めると、そう期待しがちです。
私たちも、目的だけを渡して、開発の仕組みづくりをAIに任せる実験をしました。ところがAIは、頼んでいない検査や管理の仕組みを自分で足し続け、レビューと修正の往復が止まらなくなりました。そのことに私たちが気づくまで、丸1日かかっています。
なぜ、こうなったのか。大きな理由は、目的だけでは、それを達成するための手段に上限がないことだと考えています。私たちの結論は、目的と一緒に、やらないことと終わりの条件を渡し、人が判断に入る場面を決めておく、というものです。この記事では、実験で起きたことと、そう考えるに至った理由を紹介します。
作りたかったのは、AIに任せる開発作業の共通手順
同じ組織でAIを使っていても、依頼の仕方や作業の進め方は開発者ごとに違います。その違いが、成果物の品質のばらつきにつながっていました。そこで、障害の原因調査、設計と実装、ユニットテストの実装、回帰テストといった、繰り返し行う開発作業の手順を共通化しようと考えました。
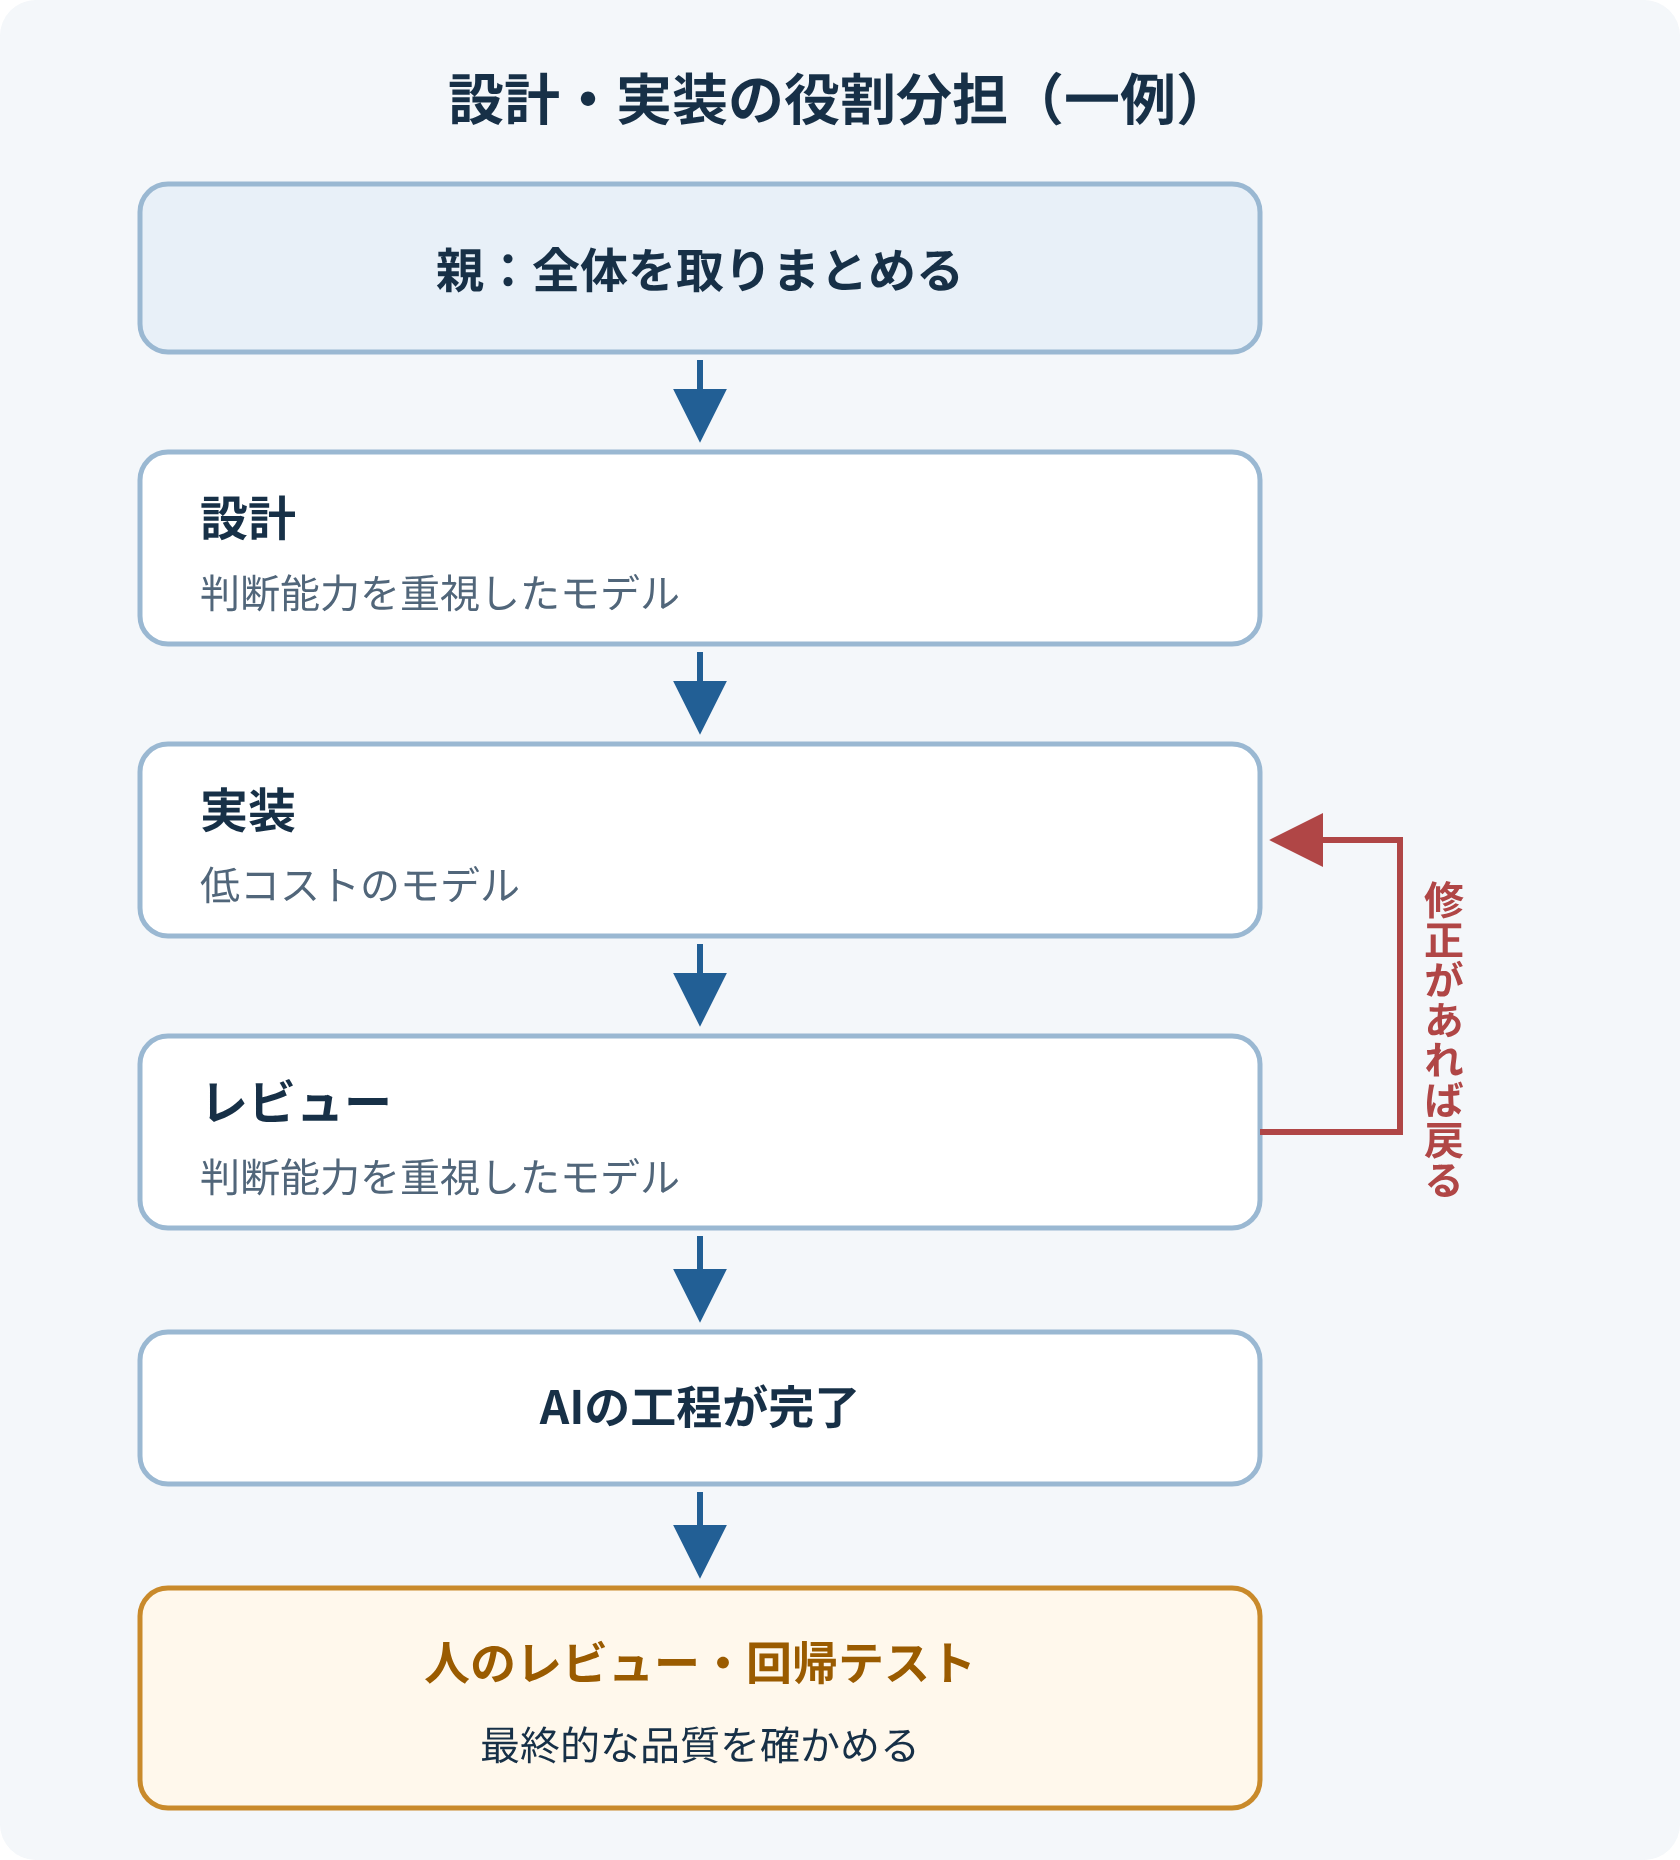
道具は二つです。一つは「スキル」で、作業の進め方をAIへの指示としてまとめたものです。もう一つは「サブエージェント」で、設計、実装、レビューといった特定の役割だけを担うAIです。全体を取りまとめるAI(以下、親エージェント)が、サブエージェント(親から見た子なので、以下、子エージェントとも呼びます)に仕事を割り振り、スキルに沿って作業を進めさせる構想でした。
利用料を抑えるため、実装には低コストのモデルを使い、設計とレビューには判断能力を重視して選んだモデルを置きました。最終的な品質は、人のレビューや回帰テストで確かめる前提です。
仕組みを作るAIが、頼んでいない検査を増やし始めた
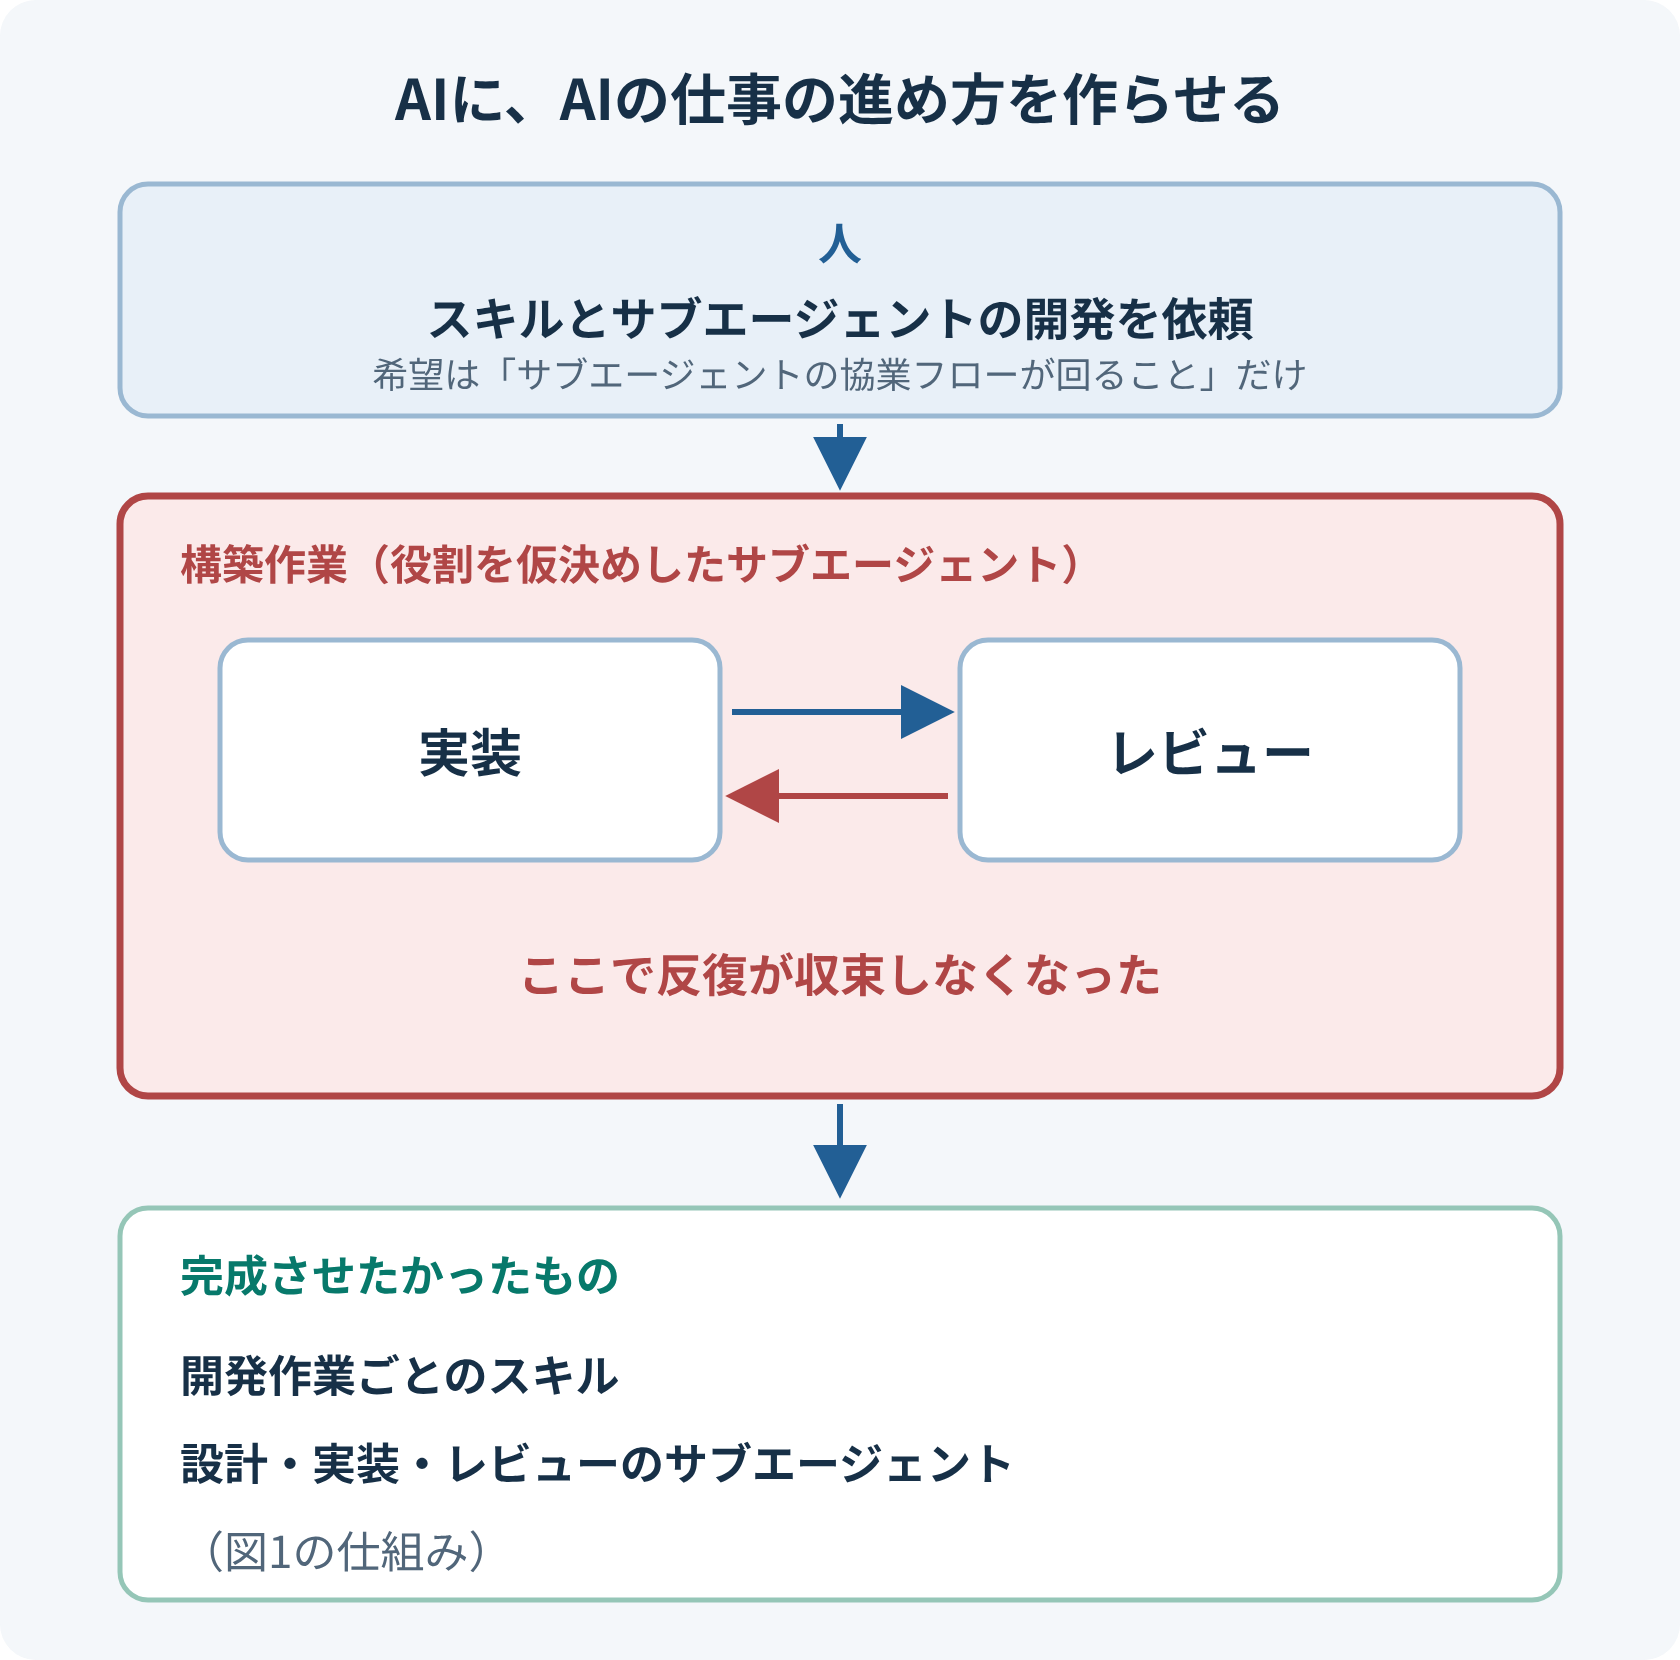
この仕組みそのもの、つまりスキルとサブエージェントの開発も、AIに任せました。役割を仮決めしたサブエージェントを用意し、企画・設計から実装、レビューまでの繰り返しを、AIだけでどこまで回せるかを試す実験です。人が伝えたのは、当初の目的(開発作業の手順を共通化すること)と、「サブエージェントの協業フローが回ること」という希望だけでした。何をやらないかや、どこで終わりにするかは伝えていません。
この希望を実現するために、AIが自分で考え出したのが「制御情報ブロック」です。各エージェントが作業結果の末尾に付ける、決まった形式のメモで、たとえば「状態:REJECT(差し戻し)」「次の担当:実装」のような項目が並びます(項目は説明用の例です)。受け取ったエージェントは、指示に従ってこのメモを読み、値が決まりどおりかを確かめてから次の作業に進みます。プログラムで照合するのではなく、AIが読んで判定する検査です。
後から出力を検証し直して分かったのは、実装とレビューを重ねるうちに、このメモや作業記録に厳密さを求める指摘が増えていったことです。説明用の例で言えば、「状態の値が定義と完全に一致しているかを、受け取る側で必ず検査すること」「各手順を実行した記録を残すこと」といった指摘です。
特に負担が大きかったのは、AIがファイルのハッシュ値を取得し、制御情報に載せて一致を確かめる仕組みを加えたことです。ハッシュ値は、ファイルの内容が変わっていないかを照合するための値です。AIは、ファイルの版の整合性まで管理し始めていました。これも、私たちが頼んだ仕様ではありません。
そして、差し戻しを伝える制御情報で、受け取る側が想定していない値が現れ、検査を通過できないことが起きました。それを直す修正と再レビューで、さらに検査が追加され、厳密になる。この繰り返しで、作業は収束しなくなっていきました。
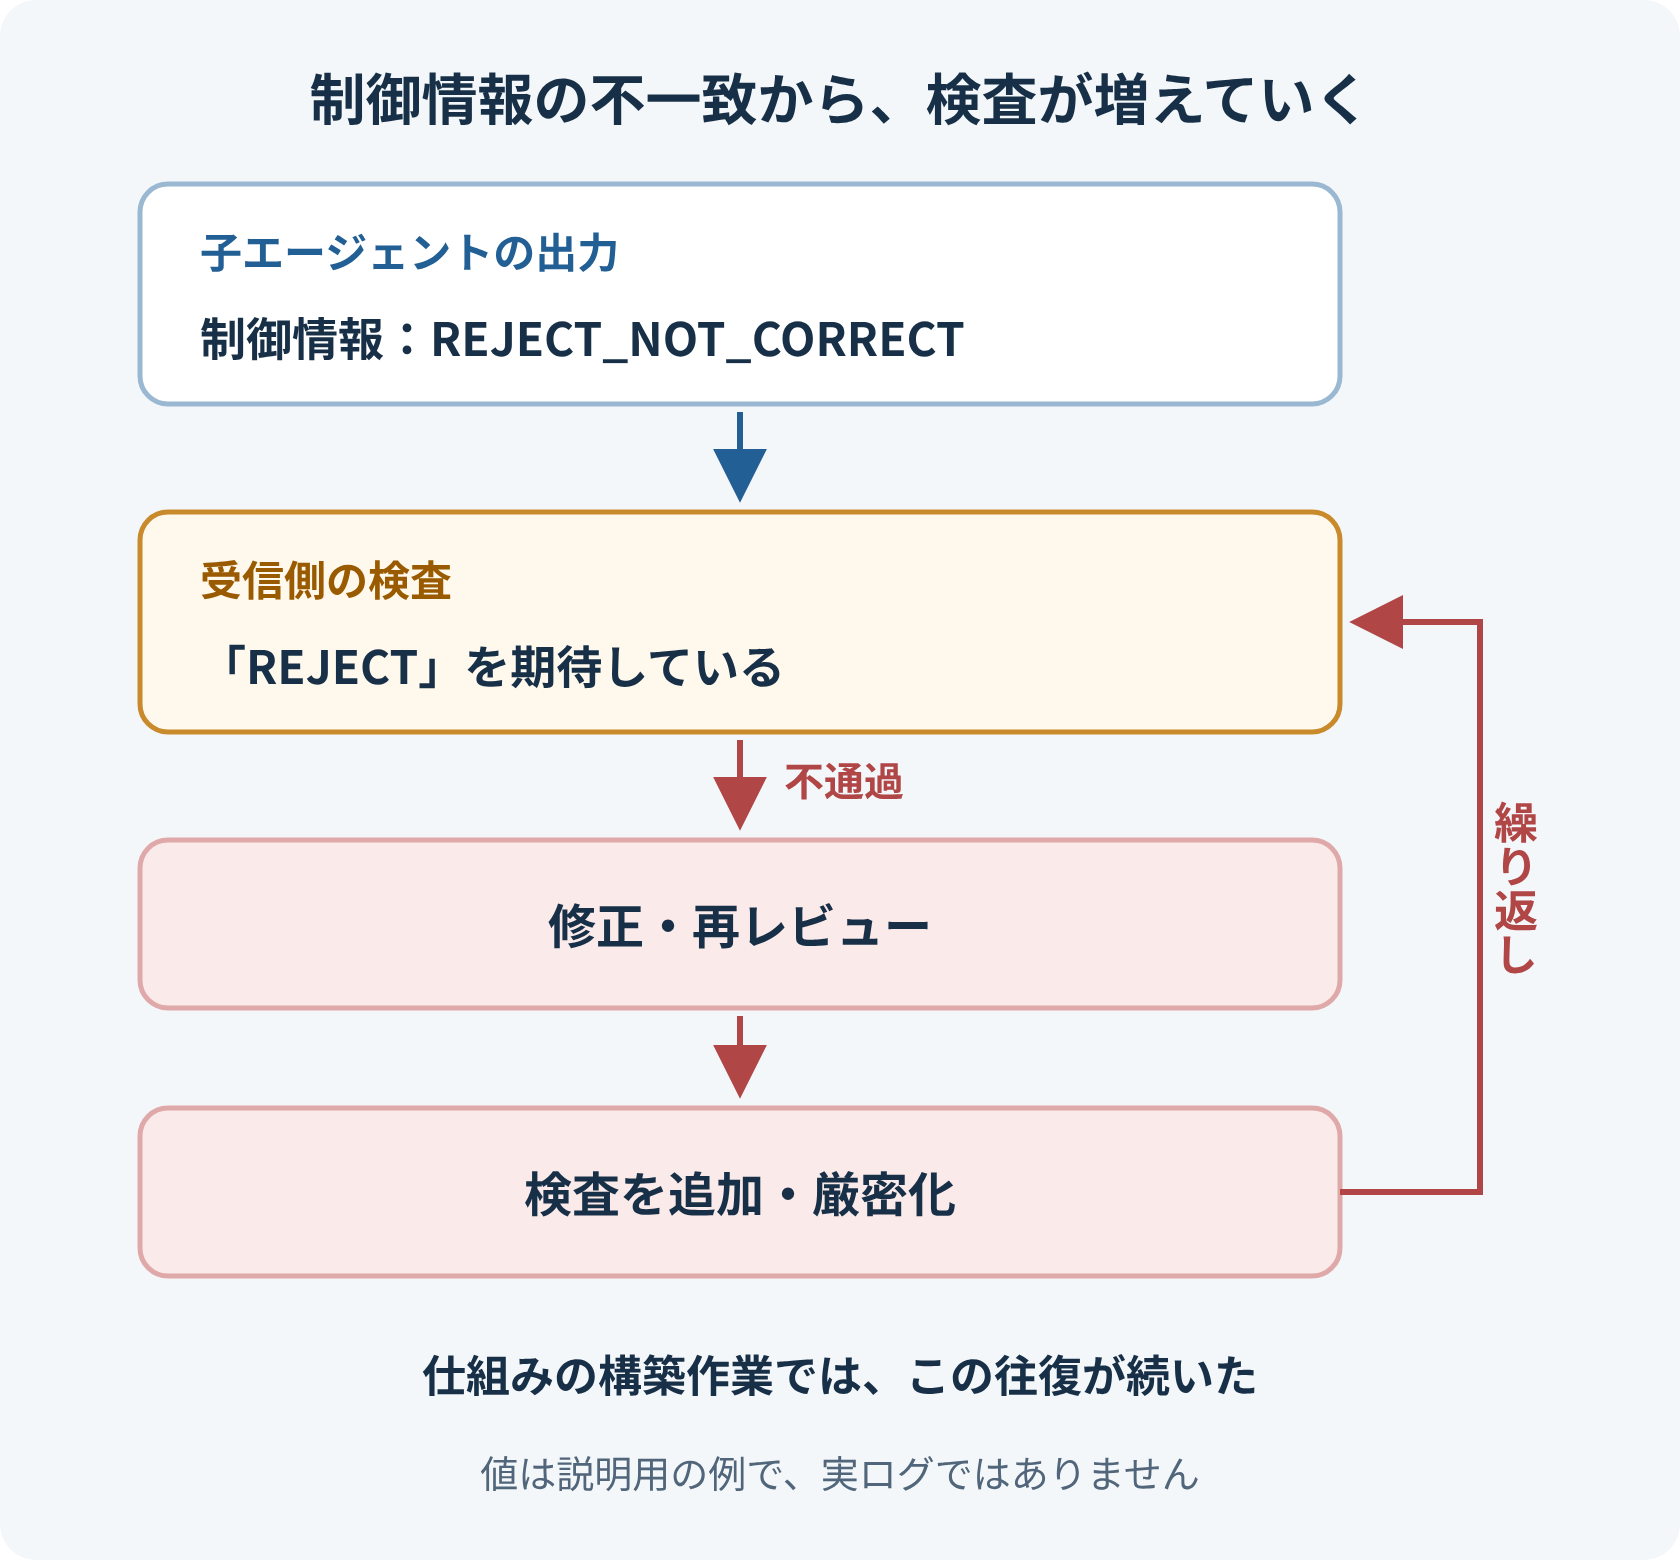
気づくまでに、丸1日かかった
その間、AIからは意図の分からない出力と、読み解くのに骨が折れる説明が大量に返ってきていました。しばらくは様子を見ていましたが、「これはおかしい」と感じて出力を人の手で検証し直したところで、ようやく状況が分かりました。作業の重心が、開発手順の共通化から、仕組みの内部を厳密に管理することへ移っていたのです。振り返れば、分かりにくい出力や説明が増えていったこと自体が、逸脱の兆しでした。
なぜ、往復が止まらなかったのか
振り返ると、三つの要因が重なり、修正の往復が自分で自分を強める循環になっていたと考えています。
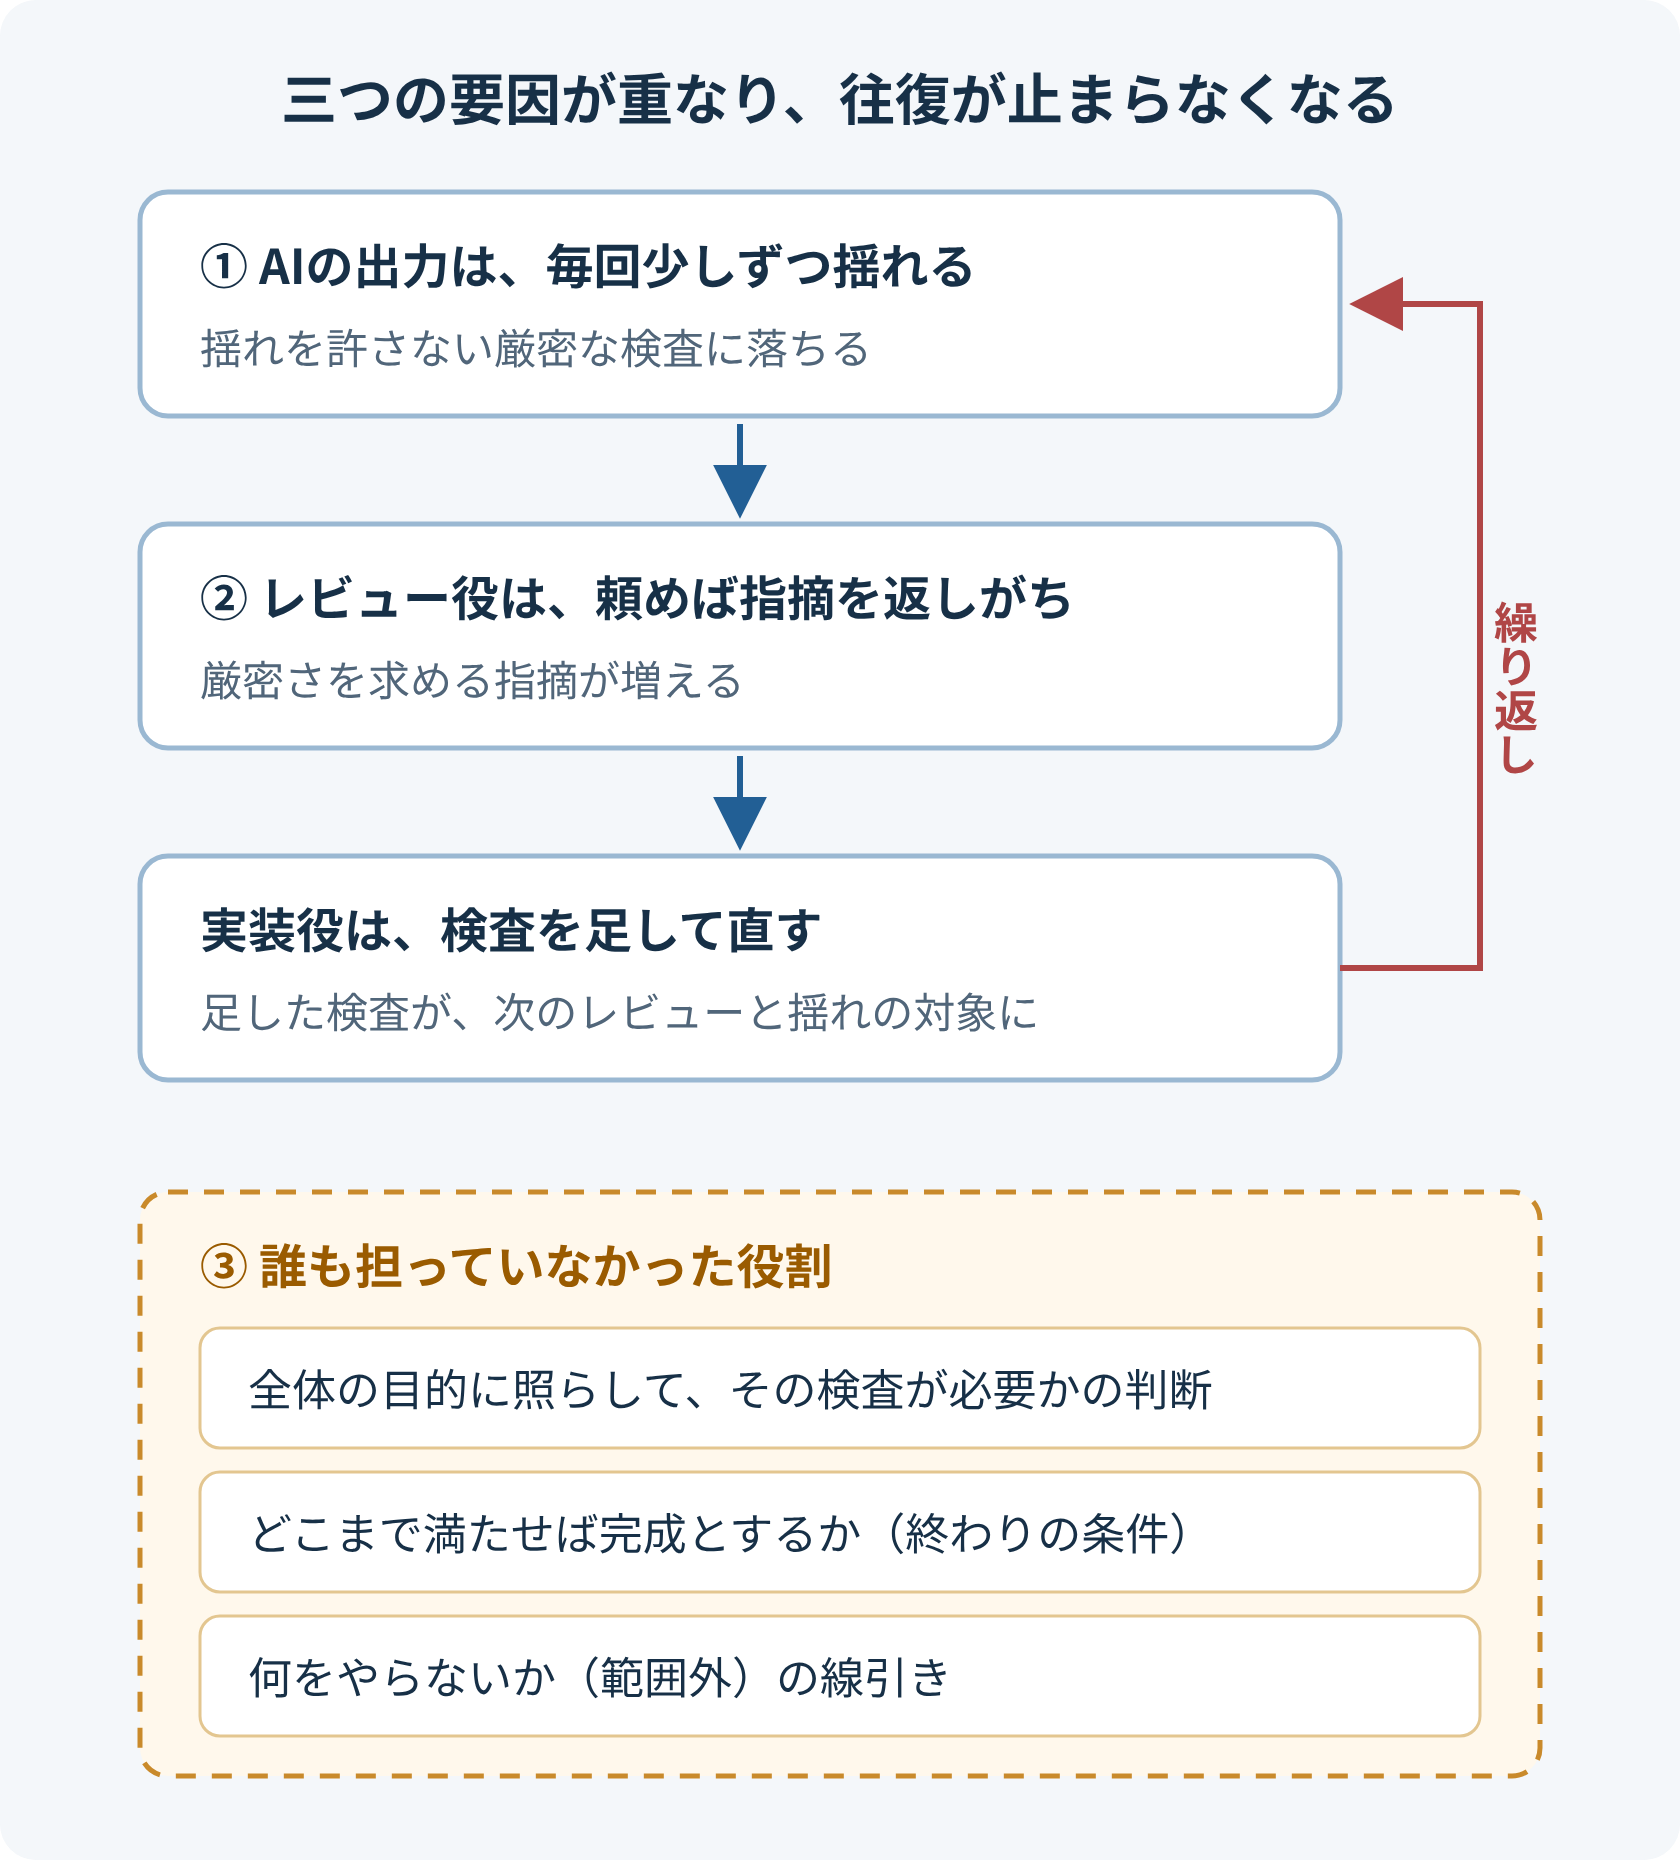
一つ目は、AIの出力が毎回少しずつ揺れることです。AIは、同じ指示を受けても、形式や表現が毎回そろうとは限りません。AIの開発元の一つであるAnthropicの公開資料も、形式を保証する専用の機能(決めた項目と形式どおりの出力しか返さないようにする機能)を使わない限り、注意深く指示しても形式の崩れや必須項目の欠落が起こりうると説明しています。[1] 今回は、メモを書く側も、それを検査する側もAIでした。どちらの側でも揺れは起こりえます。揺れを許さない厳密な検査を挟むほど、検査に落ちる場面は増えていきます。
二つ目は、レビュー役のAIは、頼まれれば指摘を返しがちなことです。レビュー役は、問題点を探すよう求められています。問題が小さくても、何かしらの指摘を返す傾向があると私たちは考えています。指摘を受けた実装役は、検査や管理の仕組みを足して応えました。足した仕組みは、次のレビューの対象になり、新たな揺れの発生源にもなります。
三つ目は、全体の目的と終わりの条件を担う役割がなかったことです。各エージェントは、目の前の指摘に応えていきました。しかし、「開発手順を共通化する」という目的に照らしてその検査が必要か、どこまで満たせば完成とするかを判断する役割は、どこにも置かれていませんでした。
さらに、私たちが渡したのは目的だけで、何をやらないか(範囲外)は渡していませんでした。目的だけでは、手段に上限がありません。版の整合性の管理も、目的のための「より確実な手段」として正当化できてしまいます。「協業フローが回ること」という希望も、私たちにとっては「最後まで動けばよい」という程度の意味でしたが、AIには「受け渡しを厳密に保証すること」として受け取られたのではないかと考えています。どの程度の確実さを求めるのかは、どこにも書いていませんでした。
複数のAIエージェントを組み合わせたシステムの失敗例を集めて分類した研究(MAST)は、失敗の型として「ステップの繰り返し」「停止条件を認識しない」「タスクの脱線」などを挙げています。[2] 今回の出来事は、これらの型に当てはまる部分が多かったと考えています。
進行管理を親に集め、目的と終わりの条件を渡し直した
立て直しでは、まず進行管理の仕組みを変えました。変更前も親エージェントはいましたが、次に進めるかどうかは、子エージェントが出した制御情報が検査を通るかどうかで決まっていました。変更後は、親エージェントが子の作業結果や報告を読み、次の作業を指示します。多少の表現の揺れがあっても、親が読み取って先へ進めます。中心のAIが仕事を分けて任せ、結果をまとめる構成は、Anthropicの技術記事でも代表的な型の一つとして紹介されています。[3]
あわせて、プロジェクトの目的と品質要求をあらためて示しました。目指すのは、当時のモデル構成で、できるだけ品質の高い成果物を得ること。最終的な品質は人とテストで確かめるので、進行管理のための中間情報には厳密さを求めず、最後まで進めることを優先する。そのうえで、親エージェントに終わりの条件を渡しました。何を満たせば完成とするかという基準と、レビューと修正の往復回数の上限です。
変更後は、完成した仕組みで、開発タスクを最後まで処理できるようになりました。複数の変更を同時に行ったため、どれがどれだけ効いたかは切り分けられません。ただ、欠けていた三つ目の役割、つまり目的に照らした判断と終わりの条件を、親エージェントに持たせたことが大きかったと考えています。
人が最初から設計に関わっていれば、別の選択肢もありました。処理の流れの制御は、決まったとおりに動く通常のプログラムに任せ、AIの出力は形式を保証する機能で縛る。そうすれば、出力の揺れが進行を止めることはありません。[1] 今回はAIにどこまで任せられるかを試す実験だったため、AIが判断する部分を残したまま立て直しました。
なお、この仕組みの組織への展開は止めています。低コストのモデルを組み合わせて利用料を下げる狙いでしたが、今回の経験から、性能の高いモデル一つにすべてを任せたほうが早く解決するのではないか、という仮説がいまは有力になっているためです。開発者ごとの品質のばらつきが改善するかどうかも、まだ確かめられていません。
この経験から考える、AIへの任せ方
目的と一緒に、やらないことを渡す
AIに設計を任せるなら、目的だけでなく、範囲外とすることも渡します。たとえば今回なら、「ファイルの版管理は対象外」「中間情報の正しさは最終的に人とテストで確かめるので、厳密な検査は作らない」といった線引きです。
目的の書き方そのものにも、注意が要ります。「フローが回ること」のような短い希望は、読み手によって求める厳密さが大きく変わります。「中間の受け渡しは多少揺れてもよい。最後まで進むことを優先する」のように、どの程度で十分なのかまで書いておけば、AIが自分で基準を引き上げる余地は小さくなるはずです。書かれていないことはAIからは見えない、という点は、「AIは書かれたことしか見ていない――開発で踏んだ3つの落とし穴」でも紹介しています。
終わりの条件と、人が判断に入る場面を先に決める
レビューと修正をAI同士で回す仕組みでは、往復がひとりでに止まるとは限りません。先に挙げたAnthropicの技術記事も、反復回数の上限などの停止条件を設けておくことが一般的だとしています。[3] 私たちが立て直しで渡したように、何を満たせば完成とするのか、何回往復したら人が判断するのかを、最初に決めておきます。
そのうえで、人が判断に入る場面を、仕組みとして決めておきます。
- 実装に入る前:AIが立てた設計や計画を、人が確認する。
- 新しい検査や管理の仕組みが追加されるとき:元のどの要求のために必要なのか、必須の対応か改善の提案かを報告させる。
- 往復が決めた回数を超えたとき、同じ種類の修正が続くとき:人が目的と構成を見直し、続けるか、進め方を変えるかを判断する。
- 検査やファイルの数が急に増えたとき:自動で人に知らせる。
AIの出力や説明が分かりにくくなってきたら、それ自体も注意信号です。今回、気づくまでに丸1日を要したのは、難解な説明が増えていく様子を、しばらく見守ってしまったからでした。人の勘だけに頼らず、機械的に立ち止まる仕組みにしておけば、こうした見過ごしは減らせるはずです。
安いモデルを組み合わせても、安くなるとは限らない
モデルの単価が低くても、レビューと修正の往復が増えれば、完了までの費用と時間は膨らみます。逸脱に気づくまでに費やした1日も、そのコストの一部です。構成を比較した研究では、単一のエージェントの能力が高まるほど、複数で協調することによる上乗せは小さくなる一方、並列に分担しやすい仕事では複数のエージェントが有利になる結果が示されています。[4] 分業にするかどうかは、分業による節約が、連携や手戻りの負担を上回るかで判断し、単純な構成から始めるのがよいと考えています。必要になったときだけ複雑さを加えるという方針は、先のAnthropicの技術記事でも示されています。[3]
一方で、当初の目的だった共通の作業手順と品質の基準は、一つのエージェントに実行させる場合にも使えます。手順は組織として残し、それをどのモデルにどう実行させるかは、費用と成果を見ながら変えていくつもりです。
実際に何をどの順で作り、どう扱ったかは、「すぐ古くなる前提で作る」で紹介しています。
参考資料
- Anthropic. Structured outputs(Claude Platform Docs)。形式を保証する機能を使わない場合に、出力の形式の崩れや必須項目の欠落が起こりうることの説明。
- Mert Cemri et al. Why Do Multi-Agent LLM Systems Fail? NeurIPS 2025, Datasets and Benchmarks Track(査読論文)。エージェントシステムの失敗を14の型に分類したMAST研究。
- Anthropic. Building effective agents 2024年12月(公式技術記事)。中心のAIが仕事を分けて任せる構成、停止条件、単純な構成から始める設計方針。
- Yubin Kim et al. Towards a Science of Scaling Agent Systems arXiv, v3, 2026年4月(プレプリント)。単一・複数エージェントの構成と、タスクとの適合性を比較。
制御情報ブロックの項目、レビューの指摘、図3の値は、説明用の例です。